
Nos engagements, en chiffres
Nos engagements chiffrés : prise en charge en moins de 10 minutes en moyenne · intervention sur site à Paris en moins de 4 heures · 97 % de SLA respectés · satisfaction client 4,7/5. Indicateurs mesurés en continu et communiqués chaque mois à nos clients (démarche ISO 9001:2015).
Beaucoup de contrats n’indiquent aucun SLA, ou le limitent à un délai de prise en charge sans engagement de rétablissement. Dans tous nos contrats d’infogérance, ils sont définis noir sur blanc : c’est ce qui nous permet de piloter l’exploitation, de voir les dérives avant le client et d’améliorer le service au lieu d’en parler.
Qu’est-ce qu’un SLA informatique ?
Le SLA (Service Level Agreement, ou accord de niveau de service) est la clause du contrat qui chiffre ce que le prestataire garantit : dans quel délai il prend en charge un incident, dans quel délai il rétablit le service, sur quelle plage horaire, et ce qui se passe s’il n’y arrive pas. Sans SLA, « réactif » et « support 7j/7 » ne sont que des adjectifs.
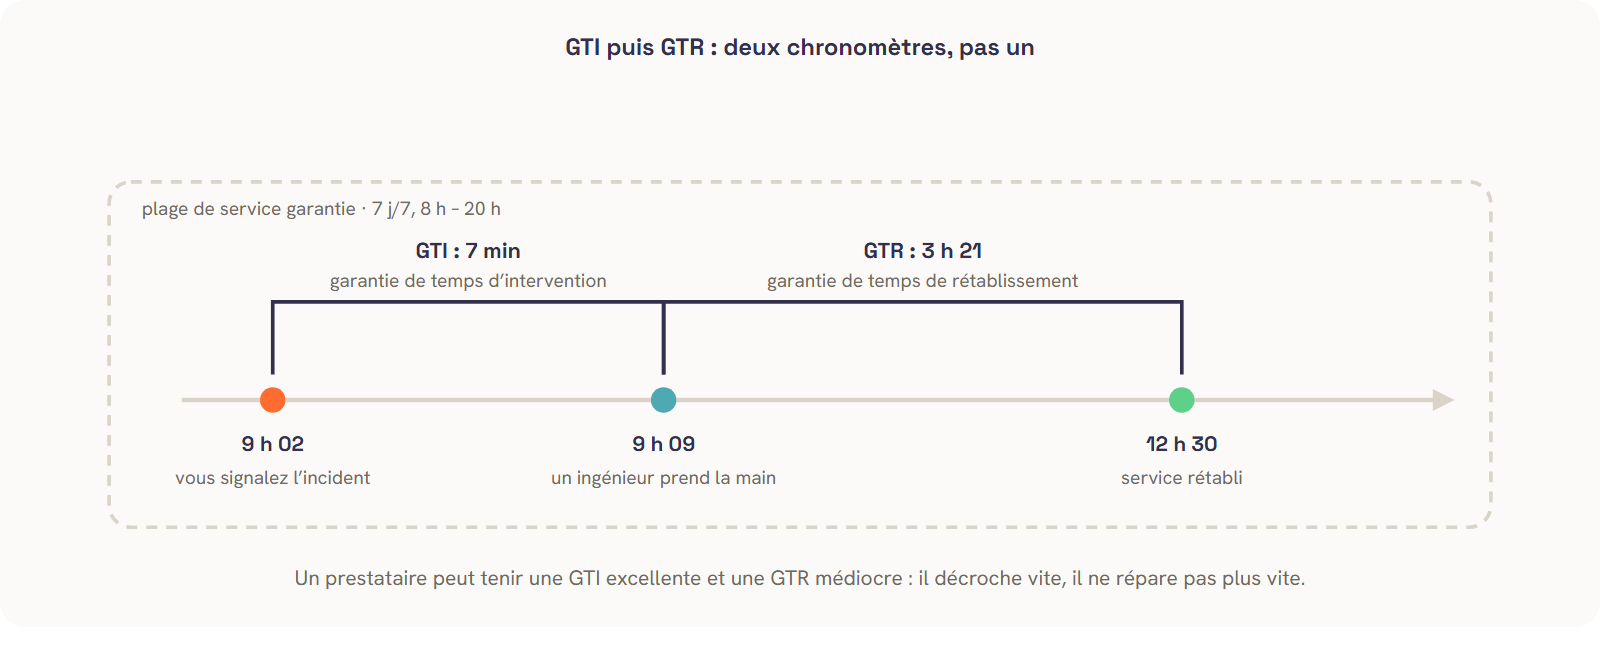
Trois notions suffisent à lire n’importe quel SLA : la plage de service garantie (les heures pendant lesquelles les engagements courent), la GTI (garantie de temps d’intervention, la prise en charge qualifiée) et la GTR (garantie de temps de rétablissement, le retour en service), détaillées sur notre page GTR informatique. Les objectifs varient selon la priorité de l’incident, qui croise impact et urgence.
Le cycle de vie d’un ticket, et où courent les chronomètres
À la création, le ticket entre en état « Nouveau » et le premier chronomètre démarre. La première réponse est le moment où la demande est acquittée, par une notification ou un appel : c’est là que le ticket est qualifié (incident ou demande de service) et que le niveau de SLA applicable est déterminé.
Le ticket passe ensuite « En cours ». Les états d’attente (« Attente client », « Attente fournisseur ») mettent les chronomètres en pause : le temps qui dépend d’un retour extérieur ne compte pas dans la mesure. À la résolution, on mesure le temps de rétablissement. Détail qui compte à l’audit : la résolution ne se confond pas avec la clôture, qui peut attendre la validation des actions correctives.
Les niveaux de priorité d’un incident :
- Critique : l’ensemble du client est impacté et les processus métiers sont interrompus sans solution de contournement (internet coupé, serveur important arrêté, réseau hors service).
- Haute : un service de l’entreprise ou un processus métier est interrompu, bloquant une partie de l’activité sans contournement possible (application arrêtée, serveur non critique, site secondaire hors ligne).
- Moyenne : un ou peu d’utilisateurs sont impactés, service non critique interrompu ou avec des solutions de contournement.
- Faible : incident non bloquant affectant un ou peu d’utilisateurs.
- Planifié : incident n’affectant pas les utilisateurs, qui sera résolu lors d’une prochaine visite ou d’une action programmée.
Cette page vous a aidé ? C’est notre métier.
- Support 8h-20h · 7j/7
- SOC 24/7
- < 10 min
- Équipe dédiée

Matrice de priorité et garanties de temps de rétablissement
La priorité d’un incident, de P1 à P4, résulte du croisement entre son impact (l’étendue de ce qui est touché) et son urgence (la gravité pour votre activité). Elle détermine la garantie de temps de rétablissement (GTR) applicable.
| Urgence ↓ / Impact → | Critique | Haute | Moyenne | Faible |
|---|---|---|---|---|
| Critique | P1 | P1 | P2 | P2 |
| Haute | P1 | P2 | P2 | P3 |
| Moyenne | P2 | P2 | P3 | P3 |
| Demande utilisateur | P4 | P4 | P4 | P4 |
Ces délais s’entendent à l’intérieur de notre plage de service garantie (7j/7 de 8h à 20h) et portent sur notre périmètre d’administration :
| Priorité | GTR : temps de rétablissement cible |
|---|---|
| P1, critique | 4 heures |
| P2, haute | 8 heures |
| P3, moyenne | 12 heures |
| P4, demande / non bloquant | 96 heures |
Un incident planifié, sans impact utilisateur, est traité lors d’une action programmée ou d’une prochaine visite, hors chronomètre GTR.
Concrètement, qui répond, et quand ?
« Support 7j/7 » ne veut pas dire grand-chose tant qu’on n’a pas dit ce qui se passe un vendredi soir. Voici trois situations, à l’heure près.
Vendredi 19h : un poste refuse de démarrer avant le comité de lundi
Vous êtes dans la plage de service. Le support est ouvert de 8h à 20h, 7j/7, week-ends et jours fériés compris. Vous avez un ingénieur au téléphone, pas un répondeur ni un formulaire à remplir. La prise en charge démarre en moins de 10 minutes en moyenne, le ticket est qualifié, et la garantie de rétablissement court à partir de cet instant. Là où beaucoup de prestataires ferment à 18h, c’est-à-dire à peu près l’heure à laquelle on découvre qu’un poste ne redémarrera pas.
Mardi 23h40 : des fichiers commencent à être chiffrés sur un serveur
Personne n’appelle, et c’est précisément le principe. La surveillance de sécurité fonctionne 24h/24 et 7j/7, et elle ne se contente pas d’envoyer une alerte : la machine est isolée du réseau, le processus est arrêté, les fichiers suspects sont mis en quarantaine. Sans attendre qu’un humain valide, parce qu’à cette heure-là chaque minute d’attente est une minute de chiffrement supplémentaire. On contient d’abord, on analyse ensuite.
Un analyste reprend la main derrière pour mesurer l’étendue de l’incident et vérifier que rien n’a essaimé sur d’autres machines, puis vous êtes prévenu selon la procédure d’escalade définie dans votre contrat. Le point qui compte : le confinement ne dépend pas de la vitesse à laquelle quelqu’un décroche.
Samedi 22h : l’imprimante du plateau ne répond plus
Autant le dire franchement, c’est le genre de détail qu’on préfère connaître avant de signer plutôt qu’un samedi soir. En dehors de la plage 8h-20h, il n’y a pas d’astreinte humaine dans le contrat standard. Une panne sans enjeu de sécurité attendra l’ouverture, le lendemain à 8h. Une astreinte dédiée existe en option, dimensionnée avec vous selon vos exigences de résilience, plutôt que facturée à tout le monde pour l’usage de quelques-uns.
Notre périmètre : nous administrons, nous n’hébergeons pas
Nos engagements portent sur ce que nous maîtrisons directement : la réactivité, l’administration, la supervision et le pilotage des restaurations. ITAIA n’est ni votre hébergeur, ni votre opérateur télécom, ni votre fabricant de serveurs. Le temps de restauration (RTO) et la perte de données maximale (RPO) après un sinistre dépendent de votre solution, du volume de données concerné et de vos fournisseurs critiques (Microsoft, hébergeur…) ; ils se définissent conjointement et se vérifient par des tests de restauration. Cette clarté des responsabilités est au cœur d’une relation conforme DORA.
Ce qu’un SLA doit contenir, et les pièges à lire avant de signer
Un SLA complet tient en six clauses : la plage de service garantie (jours et heures réels), la GTI et la GTR par niveau de priorité, le périmètre couvert et ses exclusions, la méthode de mesure, le reporting (à quelle fréquence les chiffres vous sont communiqués), et les pénalités en cas de manquement.
C’est l’ossature de tout contrat de maintenance informatique digne de ce nom : le reste du contrat décrit ce qui est fait, le SLA décrit à quelle vitesse et avec quelles preuves.
Les pièges se logent toujours aux mêmes endroits :
- Un SLA qui ne couvre que la prise en charge. Décrocher en 15 minutes n’engage à rien si aucun délai de rétablissement ne suit. Exigez la GTR.
- Des objectifs « visés » plutôt que constatés. Une cible n’est pas un résultat : demandez les chiffres réellement mesurés du trimestre écoulé, comme ceux que nous publions plus haut.
- Une plage de service théorique. « Support 7j/7 » sans horaires écrits ne dit rien d’un vendredi 19 h.
- Des pénalités décoratives. Sans reporting régulier, personne ne saura jamais qu’un SLA a été manqué ; la pénalité n’existera que sur le papier.
Ces clauses se relisent d’autant plus attentivement que l’arrêt coûte cher : notre calculateur du coût d’un arrêt informatique pose le chiffre en face des délais. Pour élargir au-delà des SLA, notre guide du prestataire informatique liste les critères vérifiables avant signature.
Questions fréquentes sur les SLA informatiques
Qu’est-ce qu’un SLA en informatique ?
C’est l’accord de niveau de service : la partie du contrat qui transforme les promesses en chiffres opposables. Il fixe la plage horaire de service, le délai de prise en charge (GTI), le délai de rétablissement (GTR) par priorité d’incident, la façon de mesurer et les conséquences d’un manquement. Un contrat d’infogérance sans SLA écrit n’engage son prestataire à rien.
Quelle différence entre GTI et GTR ?
La GTI (garantie de temps d’intervention) chronomètre le délai jusqu’à la prise en main par un technicien qualifié ; la GTR (garantie de temps de rétablissement) court jusqu’au retour en service. C’est la GTR qui protège votre activité : décrocher vite n’est pas réparer vite, et un SLA qui s’arrête à la GTI ne garantit que la rapidité de l’accusé de réception.
Quels délais attendre d’un bon SLA informatique ?
Les repères du marché pour une PME : une prise en charge en minutes plutôt qu’en heures, un rétablissement en heures pour un incident critique (4 heures chez nous en P1), en jours pour une demande non bloquante. Méfiance si tout est formulé « au mieux » ou « dans les meilleurs délais » : c’est l’absence d’engagement, en langage contractuel.
Que se passe-t-il quand un SLA n’est pas respecté ?
Selon les contrats : pénalités, avoirs ou clause de sortie facilitée en cas de manquements répétés. Mais la sanction n’est utile que si le manquement se voit : exigez un reporting périodique des délais mesurés. Chez nous, chaque dépassement est traité en écart dans la démarche ISO 9001, avec analyse de cause et action corrective suivie.
Comment vérifier qu’un prestataire tient réellement ses SLA ?
Demandez les chiffres constatés du trimestre écoulé, pas les objectifs : taux de SLA respectés, délai moyen de prise en charge, délais de rétablissement par priorité. Un prestataire qui mesure les a sous la main ; un prestataire qui promet les cherchera. Les nôtres sont publiés en haut de cette page et remis chaque mois à nos clients.
Vérifier nos chiffres
Nos indicateurs sont mesurés en continu et remis chaque mois à nos clients, dans la logique décrite sur notre page philosophie. Le modèle inverse, l’intervention à l’incident sans engagement, est décortiqué dans notre article sur le support à l’incident, et l’organisation des niveaux d’assistance sur la page support informatique.
Demandez-nous les chiffres du dernier trimestre : un ingénieur vous les montre en trente minutes, sans engagement.