Un incident informatique est un événement qui interrompt un service ou en dégrade la qualité : un poste qui ne démarre plus, une application qui plante, un serveur injoignable. Sa gestion n’est pas une affaire de réactivité brute mais de méthode : qualifier, prioriser, résoudre dans un délai engagé, puis empêcher la récidive.
Incident, demande de service, problème : trois choses différentes
Le vocabulaire compte, parce qu’il détermine le traitement. L’incident interrompt ou dégrade un service qui fonctionnait (imprimante bloquée, messagerie inaccessible). La demande de service n’est pas une panne : création d’un compte, installation d’un logiciel, droit d’accès. Le problème, au sens ITIL, est la cause racine qui se cache derrière des incidents récurrents : trois plantages identiques en un mois ne font pas trois incidents isolés, ils font un problème à traiter une bonne fois.
Un parc qui mélange les trois catégories traite tout dans le désordre : les pannes bloquantes attendent derrière des demandes de confort, et les récidives ne sont jamais vues comme telles.
Cette page vous a aidé ? C’est notre métier.
- Support 8h-20h · 7j/7
- SOC 24/7
- < 10 min
- Équipe dédiée
Un ingénieur décroche · prise en charge moyenne < 10 min · 7j/7 de 8h à 20h · devis sans frais de mise en service. Standard fermé pour le moment (ouvert 7j/7 de 8h à 20h) : choisissez votre créneau, un ingénieur vous rappelle · devis sans frais de mise en service. Simuler mon devis en ligne : prix publics dès 55 € HT par poste, résultat immédiat, aucun formulaire →

Le cycle de vie d’un incident bien géré
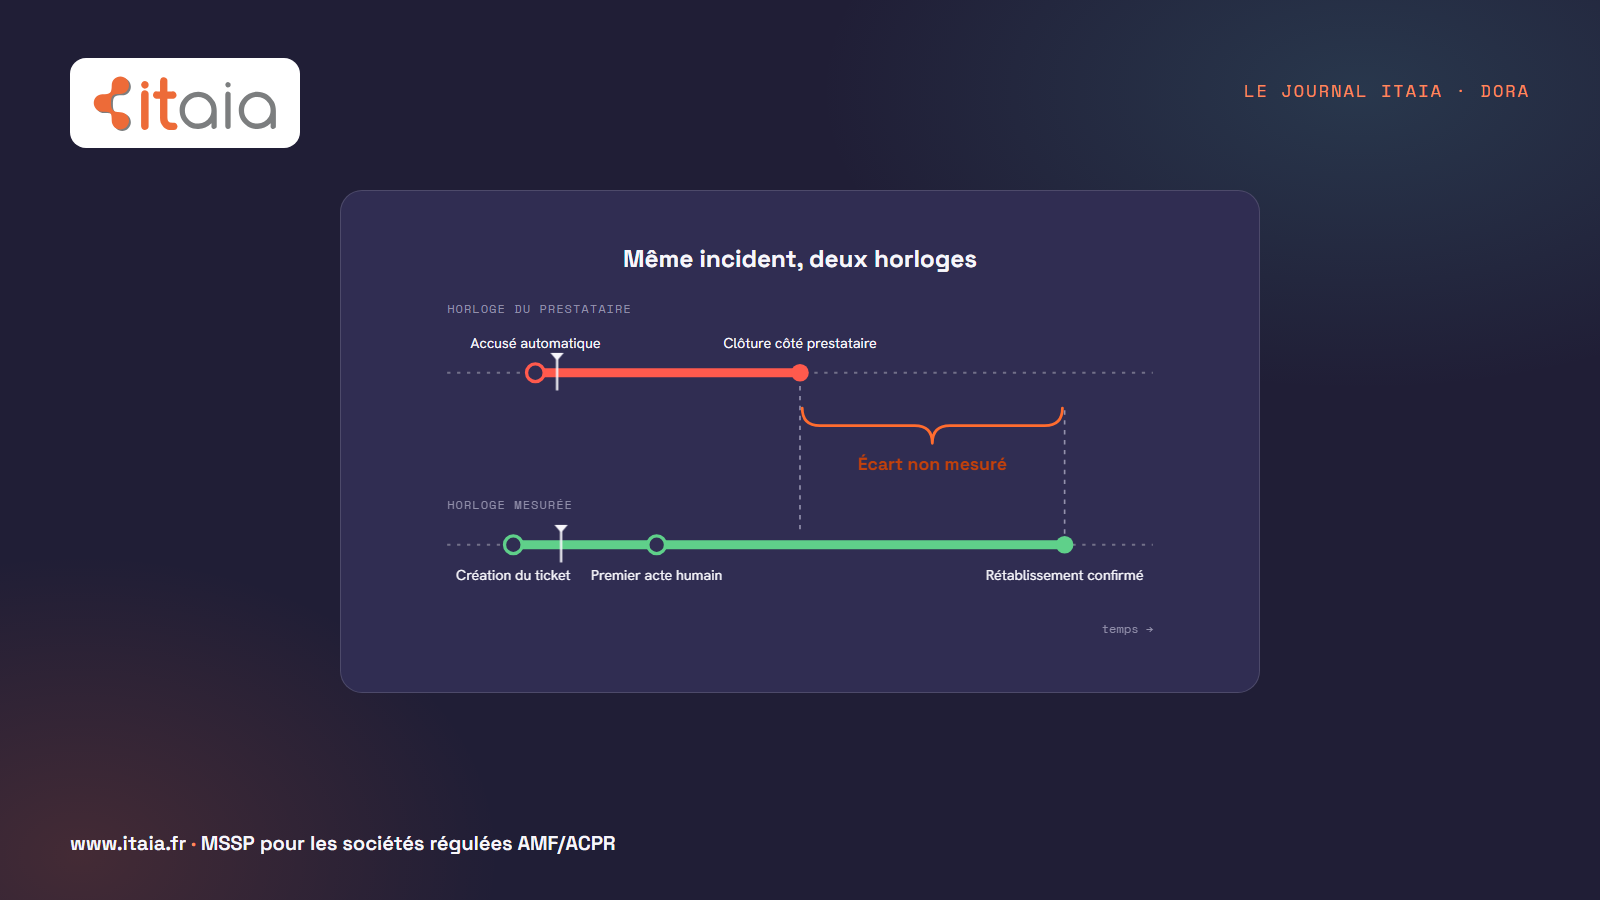
De l’enregistrement à la clôture, chaque incident suit le même chemin : il est enregistré (un ticket, jamais un couloir), catégorisé (matériel, logiciel, accès), priorisé selon son impact et son urgence, affecté au bon niveau de compétence, résolu, puis clôturé après vérification. Deux chronomètres encadrent le tout : le délai de prise en charge et le délai de rétablissement, définis dans les SLA du contrat.
La priorité, de P1 (critique : l’entreprise est à l’arrêt) à P4 (demande non bloquante), résulte du croisement entre l’impact et l’urgence : la matrice complète est publiée sur notre page SLA. Un poste isolé n’est jamais critique ; un serveur qui porte la production l’est presque toujours.
Ce qu’un système de gestion des incidents apporte
- Moins d’impact sur l’activité : les pannes bloquantes passent devant, systématiquement ;
- Les récidives deviennent visibles : le même symptôme trois fois déclenche une analyse de cause, pas une troisième réparation identique ;
- Une base de connaissances qui grossit : chaque résolution documentée accélère la suivante ;
- Des actions préventives ciblées : l’historique montre où investir, la supervision attrape les signaux avant la panne ;
- Des délais mesurables : le taux de respect des engagements se calcule, se communique et se compare.
Quand l’incident est matériel, la remise en état relève de la réparation informatique, avec l’arbitrage réparer ou remplacer qui l’accompagne. Et quand l’incident touche la sécurité, il change de nature : confinement d’abord, analyse ensuite, avec des traces conservées pour la qualification.
Questions fréquentes sur les incidents informatiques
Quelle différence entre un incident et une demande de service ?
L’incident interrompt ou dégrade quelque chose qui fonctionnait ; la demande de service ajoute ou modifie quelque chose (compte, logiciel, accès). La distinction n’est pas académique : les délais engagés ne sont pas les mêmes, et mélanger les deux files fait attendre les pannes derrière les demandes de confort.
Comment priorise-t-on un incident informatique ?
En croisant l’impact (combien de personnes et quels services sont touchés) et l’urgence (la gravité pour l’activité). Le résultat donne une priorité de P1 à P4, qui déclenche le délai de rétablissement correspondant. Ce croisement est écrit à l’avance dans le contrat : la priorité d’un incident ne se négocie pas au téléphone, elle se constate.
Qu’est-ce que la gestion des problèmes ?
C’est l’étage au-dessus des incidents : identifier la cause racine derrière les pannes récurrentes et la traiter définitivement. Un disque saturé purgé trois fois est un incident résolu trois fois ; le problème sous-jacent (dimensionnement, rétention des journaux, sauvegardes locales) n’est traité qu’une fois la cause nommée. C’est ce qui fait baisser le volume de tickets dans la durée.
Vos incidents suivent-ils un processus, ou de la bonne volonté ?
Apportez vos trois dernières pannes marquantes : en trente minutes, un ingénieur reconstitue avec vous comment elles auraient dû être qualifiées, priorisées et résolues, sans engagement.