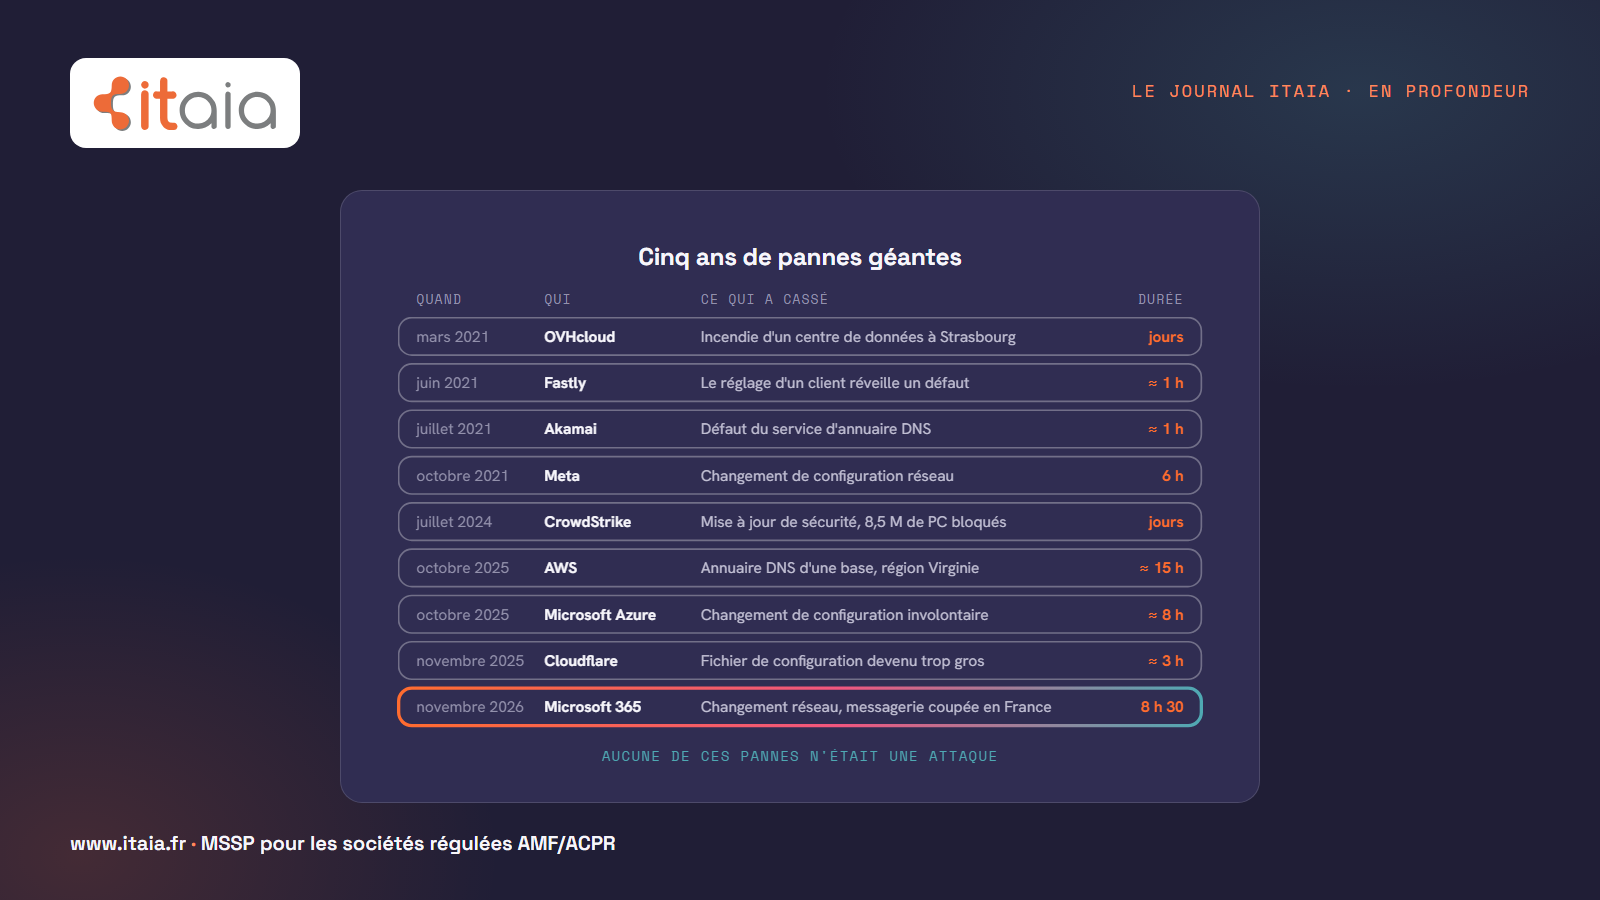
Un vendredi matin de novembre, la messagerie de Microsoft 365 a cessé de répondre en France, et elle est restée coupée environ huit heures et demie. Ailleurs dans le monde, l’incident avait commencé la veille et a duré une trentaine d’heures en tout. Selon les relevés de Downdetector cités par la presse, au moins 74 pays ont été touchés ; au Royaume-Uni, des hôpitaux publics s’en sont ressentis, aux États-Unis des services administratifs ont ralenti. Microsoft l’a dit très vite et l’a confirmé ensuite : ce n’était pas une attaque. Un changement réseau a révélé un défaut introduit lors d’une mise à niveau antérieure, et une partie des serveurs de messagerie a cessé de traiter les demandes.
Je dirige un prestataire de cybersécurité et d’infogérance. Les pannes sont notre quotidien, et celle-là, nous l’avons suivie heure par heure pour nos clients ; la chronologie complète est ici. Ce qui m’a marqué ce matin-là n’est pas la panne. C’est la phrase que j’ai entendue le plus souvent au téléphone : « on ne peut plus rien faire ». Pas « on ne reçoit plus nos messages », mais « on ne peut plus rien faire ». Une entreprise américaine a mis à l’arrêt une partie de l’économie mondiale sans le vouloir, et chacun a redécouvert à quel point il dépend d’une poignée d’acteurs qu’il ne choisit plus vraiment.
Cet article n’est pas un guide. C’est mon avis de dirigeant sur une question que tout le monde m’a posée ce jour-là, dépendance et souveraineté, et je préfère le dire d’emblée : je n’ai pas la réponse. J’ai des convictions, des doutes, et une chose à proposer en attendant.
Ce n’est pas la première fois, et ce n’est jamais une attaque
Il suffit de remonter cinq ans pour aligner une série impressionnante.
En mars 2021, un incendie détruit un centre de données d’OVHcloud à Strasbourg et une partie de son voisin. Selon Netcraft, 3,6 millions de serveurs web disparaissent d’un coup, certains pendant des jours, d’autres avec des données perdues. Des clients découvrent alors que leurs sauvegardes étaient dans le même bâtiment que leurs serveurs. C’est un hébergeur français, ce qui mérite d’être gardé en tête pour la suite.
En juin 2021, le réseau de diffusion de contenus Fastly tombe pendant près d’une heure : le réglage parfaitement valide d’un seul client réveille un défaut logiciel, et Amazon, Reddit, PayPal, Spotify ou le New York Times deviennent inaccessibles. Le mois suivant, c’est le service d’annuaire DNS d’Akamai, autre géant de la diffusion : environ une heure, et Airbnb, American Express, Delta Air Lines ou UPS ne répondent plus. En octobre de la même année, un changement de configuration réseau efface Facebook, Instagram et WhatsApp d’internet pendant six heures.
En juillet 2024, une mise à jour défectueuse de CrowdStrike, un outil de protection des postes de travail, bloque au démarrage environ 8,5 millions d’ordinateurs Windows, moins de 1 % du parc mondial selon Microsoft. Cela suffit pour clouer des milliers d’avions au sol, reporter des rendez-vous médicaux et perturber des paiements en magasin, et il faut des jours pour tout remettre en route, poste par poste. L’assureur Parametrix estime les pertes directes des seules entreprises du Fortune 500 à 5,4 milliards de dollars. Ironie de l’histoire : c’est l’outil chargé de protéger qui a arrêté le monde.
L’automne 2025 a été particulièrement chargé. En octobre, la région de Virginie d’Amazon Web Services perd la résolution DNS d’une de ses bases de données internes : une quinzaine d’heures de perturbations en cascade, de Snapchat aux jeux en ligne en passant par les objets connectés. Quelques jours plus tard, un changement de configuration involontaire sur le service d’entrée de trafic de Microsoft Azure perturbe Microsoft 365, Xbox et de nombreux sites pendant environ huit heures. En novembre, c’est Cloudflare : un fichier de configuration généré automatiquement double de taille, dépasse une limite du logiciel qui aiguille le trafic, et une bonne partie du web, ChatGPT, X ou Canva compris, renvoie des erreurs pendant environ trois heures, avant un retour complet près de six heures après le début.
Regardez la colonne des causes. Pas un pirate, pas une puissance étrangère. Un incendie, et pour tout le reste un changement : une mise à jour, une configuration, un fichier un peu plus gros que prévu. Les plus grandes pannes de l’histoire d’internet sont des accidents d’exploitation chez des acteurs parmi les plus compétents du monde. C’est rassurant sur un point, ce n’est pas la guerre. C’est inquiétant sur un autre : on ne s’en protège pas avec un pare-feu.
Pourquoi tout tombe en même temps
Ces pannes ne sont pas plus fréquentes qu’avant. Un petit serveur de messagerie installé dans un placard tombe bien plus souvent que Microsoft 365. La différence, c’est que lorsque le placard tombe, une seule entreprise s’arrête, et personne n’en parle.
Ce qui a changé, c’est la concentration. Selon Synergy Research, Amazon, Microsoft et Google se partagent environ 70 % du marché européen de l’informatique en nuage ; l’ensemble des fournisseurs européens pèse autour de 15 %, une part qui ne bouge plus depuis plusieurs années. Côté diffusion des sites, une poignée d’entreprises se tient devant la majorité du trafic. Et ce mouvement a d’excellentes raisons : ces acteurs sont, en moyenne, plus fiables, mieux protégés et moins chers que tout ce qu’une entreprise de vingt ou deux cents personnes pourrait construire seule.
Mais la concentration change la nature du risque. Quand tout le monde est chez le même fournisseur, les pannes deviennent simultanées. Ce vendredi-là, vous n’étiez pas seul à ne plus avoir de messagerie : votre client, votre banque, votre expert-comptable, votre fournisseur et votre prestataire informatique étaient dans le même cas, au même moment. Le risque n’est plus individuel, il est systémique. Les assureurs parlent de risque d’accumulation, les régulateurs financiers de risque de concentration.
Le régulateur européen en a d’ailleurs tiré la conséquence. Fin 2025, les trois autorités européennes de supervision financière ont désigné, au titre du règlement DORA, dix-neuf prestataires informatiques « critiques » pour le secteur financier, parmi lesquels Amazon Web Services, Google Cloud, Microsoft, Oracle, SAP, IBM, Orange et Deutsche Telekom. Ils sont désormais sous la surveillance directe des autorités européennes. Ce n’est pas un reproche, c’est un constat : quand ils tombent, la finance européenne vacille avec eux.
Une partie de cette dépendance ne se gère d’ailleurs pas du tout. Vous ne choisissez pas le réseau de diffusion du site de votre banque, ni l’opérateur qui transporte le trafic entre deux continents, ni l’hébergeur du logiciel en ligne de votre expert-comptable. Le jour où Cloudflare ou Akamai tombe, la moitié des sites que vous consultez tombe avec, et aucune décision prise dans votre entreprise n’y change rien.
Être souverain, mais pour parler à qui ?
Le mot souveraineté est revenu partout ce jour-là, et j’avoue qu’il m’a laissé perplexe. Alors j’ai fait l’expérience jusqu’au bout. Imaginons que j’aie eu, ce vendredi, mon propre serveur de messagerie sous Linux, dans une baie au bureau ou chez un petit hébergeur français.
Il aurait fonctionné. Et alors ? Mes clients, ma banque, mes fournisseurs, la plupart de mes interlocuteurs étaient chez Microsoft. Ils ne pouvaient pas m’écrire, et je ne pouvais pas leur répondre utilement puisqu’ils ne recevaient rien. La messagerie est un système à deux bouts : avoir le sien qui fonctionne quand l’autre bout est coupé, c’est avoir un téléphone qui marche dans une ville où toutes les lignes sont tombées. J’aurais eu mes messages, mais personne pour m’en envoyer.
Il y a plus. La messagerie est conçue depuis l’origine pour supporter les pannes : un serveur qui n’arrive pas à remettre un message le garde et réessaie, et la norme recommande de persévérer au moins quatre à cinq jours avant d’abandonner. C’est exactement ce qui s’est passé : les messages envoyés pendant la coupure sont arrivés en retard, mais ils sont arrivés. Le serveur maison m’aurait apporté quelques heures d’avance sur des messages que je n’aurais de toute façon pas reçus.
Voilà la question que je n’arrive pas à trancher : à quoi me sert d’être souverain si tous ceux avec qui je travaille sont en panne en même temps ? La souveraineté individuelle, dans un monde qui ne l’est pas, ressemble à une île très bien gardée au milieu d’un océan à sec.
Les géants ou une structure à taille humaine, et à quel prix ?
La vraie alternative n’est d’ailleurs pas entre les géants et rien. Elle est entre les géants et des structures de taille moyenne : un hébergeur régional, un éditeur européen, un prestataire qui fait tourner pour vous des logiciels libres dans un centre de données français. J’ai regardé ces options sérieusement, pour nous et pour nos clients. Voici ce que j’en pense, sans certitude.
Le prix, d’abord. Il ne se mesure pas seulement en euros par utilisateur, même si la facture est souvent plus élevée. Il se mesure en fonctionnalités, en intégration avec les outils de vos correspondants, en temps passé par vos équipes à faire cohabiter deux mondes. Une société de gestion qui quitte Microsoft continuera de recevoir des invitations Teams, des documents partagés depuis SharePoint et des formulaires de ses dépositaires conçus pour l’écosystème dominant.
La dépendance, ensuite. Elle ne disparaît pas, elle change de taille. Au lieu de dépendre d’un géant qui emploie des milliers d’ingénieurs, on dépend d’une équipe de quelques dizaines de personnes, parfois de quelques personnes, de leurs vacances, de leur santé, de leur rachat. Avec un serveur maison, c’est pire : on est marié avec le mainteneur. Il faut des correctifs de sécurité appliqués le jour même, un filtrage des indésirables entretenu, une réputation d’envoi défendue auprès des grands fournisseurs qui filtrent sévèrement les petits serveurs, des sauvegardes testées. Au printemps 2021, des dizaines de milliers de serveurs Exchange installés dans les entreprises ont été compromis en quelques jours par une faille qui ne touchait pas la messagerie en ligne de Microsoft. On échange un risque rare et partagé, que la presse couvre et que tout le monde comprend, contre un risque plus fréquent et solitaire, que personne ne voit. Nous avons fait le même calcul pour les serveurs de fichiers dans notre article sur le serveur d’entreprise ; pour la messagerie, il est encore plus net.
Et la souveraineté, enfin, ne protège pas de la panne. OVHcloud est français, et ses serveurs ont brûlé. Un fournisseur européen fait des mises à jour, des changements de configuration et des erreurs comme les autres. Elle répond à une autre question, qui est réelle : qui peut accéder à vos données, et qui peut décider de vous couper. En juin 2025, sous serment devant une commission d’enquête du Sénat, le directeur des affaires publiques et juridiques de Microsoft France a reconnu ne pas pouvoir garantir que des données hébergées en Europe ne seraient jamais transmises aux autorités américaines sur injonction, la loi américaine s’appliquant à l’entreprise où que soient stockées les données. Microsoft précise que, selon ses rapports de transparence, aucune demande de ce type n’a porté à ce jour sur des données stockées en Europe. Les deux affirmations sont vraies en même temps, et c’est tout le problème : le risque juridique existe même s’il ne s’est pas réalisé.
Une question qui reste entière
Je ne crois pas que la réponse viendra des entreprises une par une. Une société de vingt personnes qui quitte seule les géants paie plus cher, travaille moins bien avec ses partenaires, et reste en panne le jour où ses clients le sont. Elle ne viendra pas non plus d’un acteur providentiel, ni de l’intelligence artificielle : les grands modèles tournent pour l’essentiel chez les mêmes trois fournisseurs, et chaque assistant que l’on branche sur sa messagerie ajoute une dépendance plutôt qu’il n’en retire une.
Si une réponse vient, elle viendra peut-être de l’État et de l’Europe, parce que la souveraineté est un sujet collectif : il ne sert à rien d’être indépendant seul. Qualifier des offres de confiance, comme le fait l’ANSSI avec SecNumCloud, faire basculer les administrations et les grands donneurs d’ordre, créer un marché assez large pour que des acteurs européens atteignent la taille critique : c’est à cette échelle que l’équation peut changer. Je l’espère, je n’en suis pas sûr, et je ne vois pas d’échéance.
En attendant, la question reste entière. Et je refuse de répondre à une question entière par un slogan, dans un sens ou dans l’autre.
En attendant, faites votre analyse de risque
Ce que je sais, en revanche, c’est qu’on ne décide pas bien d’un risque qu’on n’a pas regardé en face. Il existe une méthode pour cela, elle est française, elle est publique, et elle marche : EBIOS Risk Manager, la méthode d’analyse de risque de l’ANSSI. Je la recommande ici pour une raison précise : elle oblige à regarder son écosystème. Un de ses ateliers consiste à cartographier les parties prenantes dont on dépend, à mesurer cette dépendance et l’exposition qu’elles créent, et à décider lesquelles sont critiques. C’est exactement l’exercice qui manquait à beaucoup ce vendredi-là.
Concrètement, l’analyse vous fait passer par quelques questions simples, qu’il vaut mieux se poser à froid.
Ce sans quoi l’entreprise ne fonctionne pas une journée : messagerie, identité, fichiers, téléphonie, logiciel métier, banque en ligne, signature électronique, site. Pour chaque ligne, qui l’opère réellement, ce qui se passe s’il disparaît, et combien de temps c’est supportable. La ligne la plus importante est souvent celle qu’on oublie : l’identité. Le compte avec lequel on se connecte à tout est la porte commune de tous les services ; le jour où elle se ferme, tout se ferme en même temps.
Ce que cela coûte. Prenons, à titre d’exemple, une société de gestion de vingt personnes, avec un coût complet moyen de 70 euros de l’heure par collaborateur. Huit heures et demie sans messagerie, alors que les fichiers et Teams fonctionnaient : comptons la moitié du temps réellement perdu. Cela fait environ 6 000 euros, plus ce qui ne se mesure pas en heures, un ordre qui n’est pas parti, un client qui a attendu. Si une coupure de cette ampleur survient tous les deux ou trois ans, ce qui ressemble à ce qu’on observe depuis cinq ans, le coût moyen ressort entre 2 000 et 3 000 euros par an. C’est désagréable, ce n’est pas vital, et c’est très inférieur au coût de n’importe quelle architecture de messagerie doublée. Notre calculateur du coût d’un arrêt informatique vous donne votre propre ordre de grandeur en une minute. Au passage, l’engagement de disponibilité de 99,9 % de Microsoft tolère environ 43 minutes d’indisponibilité par mois, et le dédommagement prévu, quand il s’applique, est un avoir sur l’abonnement : un engagement de service n’est pas une assurance.
Ce que l’on fait du risque : l’accepter, le réduire, le partager. Pour la panne d’un géant, l’analyse conclut presque toujours à accepter le risque de fond et à réduire son impact là où cela coûte peu.
Réduire l’impact à peu de frais, cela tient en quelques briques séparées et quelques réflexes. Le nom de domaine et sa zone DNS à votre nom, chez un registraire distinct de votre fournisseur de messagerie, pour garder la liberté de rediriger ou de partir. Une sauvegarde de vos données hors du fournisseur principal ; l’incendie de Strasbourg a montré ce que vaut une sauvegarde rangée dans le même bâtiment que l’original. Une téléphonie qui ne dépend pas de la messagerie. Une liste des numéros utiles sur papier et dans les téléphones, et un groupe de messages qui ne passe pas par l’outil principal : beaucoup d’entreprises ont découvert ce jour-là qu’elles ne savaient plus joindre leurs propres équipes. Des messages types prêts pour vos clients, une règle claire sur qui décide et qui prévient. Et une heure d’exercice par an autour d’une table, avec un scénario simple : « vendredi matin, plus de messagerie pendant huit heures ». Si vous n’avez pas de plan de continuité, notre exemple de plan de continuité donne une trame.
Pour commencer l’analyse, notre simulateur EBIOS RM produit en dix minutes une esquisse fidèle de ce que donneraient les ateliers : scénarios, matrice, risques résiduels. Ce n’est pas un livrable de conformité, c’est un point de départ. L’analyse réelle se conduit en ateliers, pilotée par votre direction ou par un cabinet indépendant ; celui qui exploite votre système ne doit pas être seul juge de ses risques, et nous y participons pour apporter la connaissance technique.
Pour les acteurs soumis à DORA
Pour nos clients du secteur financier, tout cela n’est pas une option. Le règlement DORA demande d’évaluer le risque de concentration avant de confier une fonction importante à un prestataire informatique (article 29), de tenir un registre de ces prestataires, et de disposer pour chaque fonction critique d’une stratégie de sortie documentée et testée (article 28). La désignation de Microsoft, d’Amazon ou de Google comme prestataires critiques ne transfère aucune responsabilité : l’entité financière reste seule responsable de sa résilience.
Cette panne doit trouver sa place dans le registre des incidents, avec ses deux moments : l’incident Microsoft dans son ensemble, d’une trentaine d’heures, et la coupure franche constatée en France, d’environ huit heures et demie. Elle est aussi l’occasion de relire l’analyse de concentration, en se demandant ce qui, chez vous, dépend du même fournisseur que la messagerie, et de vérifier que la chaîne de vos prestataires est connue jusqu’au dernier maillon.
Ce que je retiens
Dépendre n’est pas une faute. C’est le prix d’un service que presque aucune entreprise ne pourrait s’offrir seule, avec un niveau de sécurité qu’elle n’atteindrait jamais seule. La faute, c’est d’ignorer de quoi l’on dépend, de ne pas savoir ce que coûte une journée sans, et de découvrir le matin de la panne qu’on n’a même pas les numéros de téléphone de ses propres équipes.
Sur la souveraineté, je reste partagé. Je vois le risque juridique et politique, je vois la fragilité de la concentration, et je vois aussi qu’aucune entreprise ne la corrigera seule sans se pénaliser. Je préfère le dire que faire semblant d’avoir une solution à vendre. Ce que nous faisons, nous, est plus modeste : l’environnement Microsoft de chaque client est à son nom et non au nôtre, ses sauvegardes sont hors du fournisseur principal, et le jour de la panne nos clients ont été prévenus tôt, par téléphone et par une page de suivi tenue à jour toute la journée. Nous allons maintenant faire ce que je recommande ici : rejouer la journée, chronométrer, et corriger ce qui a manqué.
Et vous, si vos principaux outils tombaient demain matin pour huit heures, sauriez-vous ce que cela vous coûte, et qui vous appelleriez en premier ?
Si vous voulez y réfléchir à deux, Marin ou moi vous recevons trente minutes, sur rendez-vous, et l’état des lieux initial est offert.
Gregory Moulis, directeur général d’ITAIA
Sources
- ITAIA, Panne mondiale de Microsoft 365 : chronologie, causes et conduite à tenir, novembre 2026 : heures officielles, cause communiquée par Microsoft, coupure constatée en France.
- Futura, Panne géante chez Microsoft : ce que ce blocage mondial d’Outlook révèle sur notre dépendance, novembre 2026 : pays touchés selon Downdetector, hôpitaux britanniques, services publics.
- Boursorama, Pannes informatiques majeures de ces dernières années, novembre 2026 : récapitulatif des pannes de Meta, Fastly, Akamai, CrowdStrike, AWS et Cloudflare.
- Journal du Net, Six choses qu’OVH ne dit pas sur l’incendie de Strasbourg, et Siècle Digital, Incendie OVH : les données, mars 2021 : centre de données détruit, chiffres Netcraft, sauvegardes perdues.
- Fortune, Internet outage hits PlayStation, airlines and banks, juillet 2021 : panne du service DNS d’Akamai et sites touchés.
- Cybersecurity Dive, CrowdStrike outage cost Fortune 500 companies $5.4B, juillet 2024 : estimation de Parametrix ; TechTarget, Explaining the largest IT outage in history : 8,5 millions d’appareils selon Microsoft, transport aérien.
- InfoQ, AWS DynamoDB outage postmortem, novembre 2025 : cause et durée de la panne d’octobre 2025.
- TechRepublic, Microsoft Azure suffers global outage, octobre 2025 : changement de configuration du service d’entrée de trafic, services touchés.
- Cloudflare, Cloudflare outage on November 18, 2025 : rapport officiel, fichier de configuration, durées.
- Synergy Research Group, European cloud providers’ local market share now holds steady at 15%, juillet 2025.
- Autorités européennes de supervision, European Supervisory Authorities designate critical ICT third-party providers, novembre 2025.
- Sénat, compte rendu de la commission d’enquête sur la commande publique, audition de Microsoft France, juin 2025.
- IETF, RFC 5321, Simple Mail Transfer Protocol, section 4.5.4.1 : durée de nouvelle tentative de remise des messages.
- CERT-FR, Alerte CERTFR-2021-ALE-004 : vulnérabilités dans Microsoft Exchange Server, mars 2021 : serveurs installés dans les entreprises concernés, messagerie en ligne non concernée.
- ANSSI, la méthode EBIOS Risk Manager : ateliers, cartographie de l’écosystème et des parties prenantes.
- Règlement (UE) 2022/2554 sur la résilience opérationnelle numérique du secteur financier (DORA), articles 28 et 29.